
前情提要
截至 Day 18 為止,地端環境中的運算節點、儲存設備與災難復原演練都已具備可重複驗證的資料證據。然而,這些資料目前分散在四個獨立角落:Day 12 的hw-sample.py將溫度與記憶體寫入節點本機 JSON,Day 17 的nas-audit.sh輸出 Markdown 報告,Day 15 的 PVEcheck.sh仰賴手動執行,Day 16 至 18 的drills.jsonl則各自散落在三個不同的程式碼倉庫中。目前沒有任何單一介面能同時掌握 GPU 節點的熱浸潤(Thermal Soak)、NAS 儲存池與快照變化、PVE 叢集 HA 狀態,以及距離上一次還原演練成功究竟過了幾天。第三階段的核心任務就是從「分散取樣」邁向「統一觀測」,今天先完成指標收集,Day 20 再進行視覺化與告警建置。
在著手導入監控系統前,先盤點前十八天累積的七種取樣來源及其儲存現況:
| 來源類型 | 目標設備 | 產生機制 | 輸出格式 | 取樣頻率 | 現況瓶頸 |
|---|---|---|---|---|---|
| 熱度與統一記憶體 | DGX Spark 兩台 | Day 12 hw-sample.py |
fsync JSONL | 預設 3 秒一次 | 僅存於節點本機 |
| 主機記憶體防護 | DGX Spark 兩台 | Day 12 gb10-host-guard.py |
systemd journal | 事件觸發 | 僅能事後翻查日誌 |
| 儲存池與快照 | QNAP NAS 兩台 | Day 17 nas-audit.sh |
Markdown | 人工觸發 | 無法自動追蹤趨勢 |
| 磁碟與系統溫度 | QNAP NAS 兩台 | 無 | 無 | 無 | 尚未納入收集 |
| 虛擬化叢集與 HA | PVE 兩台 + QDevice | Day 15 check.sh |
指令文字輸出 | 人工觸發 | 無法歷史回溯 |
| 災難還原演練 | 三個程式庫 | Day 16, 17, 18 演練腳本 | drills.jsonl |
每次演練產生 | 散落各專案目錄 |
| 異地雲端副本 | GCS Bucket | Day 18 offload-drill.sh |
drills.jsonl |
每次上傳產生 | 同上 |
node_exporter,hw-sample.py 也未以 systemd daemon 形式背景化。noAuthNoPriv,次要 NAS 尚未啟用;本次統一部署提升為 authPriv 安全等級。在無既有歷史包袱的前提下,監控系統的選型主要考量兩項原則:連線架構(Who connects to whom) 與 儲存資源消耗。
/metrics。被監控主機只需於本機暴露特定 HTTP 埠,完全不需感知收集端的 IP 或位置;未來收集端搬遷或擴展時,受控節點零改動。9100 給收集端 IP。up == 0,這項原語本身就是高可靠的心跳訊號,無須額外開發外部健康檢查機制。VictoriaMetrics 在資源消耗與壓縮率上表現極佳,適合大規模時序場景。但在此場域中,總活躍序列數約為 7,700 條(詳見第五節實測),Prometheus 容器常駐記憶體僅約 119 MiB。在此規模下,兩者的效能與記憶體差異並不顯著。選擇 Prometheus 的核心價值在於其生態系成熟度、Exporter 相容性,以及與 Grafana 銜接的高普及度。經容量精算後,本場域將資料保留期(Retention)設定為 90 天。
面對不同設備與業務指標,整合原則為:標準硬體與作業系統指標交由官方 Exporter,專用硬體特性與業務歷史則透過 node_exporter 的 Textfile Collector 進行擴充補足。
Textfile Collector 是一種簡潔可靠的通訊協議:任何背景工作只需原子性(Atomic Write)地將符合 Prometheus 格式的文字寫入 .prom 檔案,node_exporter 即可在下次抓取時對外暴露。
實作細節:暫存檔權限陷阱
使用 Python 的tempfile.mkstemp建立暫存檔時,預設檔案權限為0600。若未做權限變更就直接原子替換(rename),以非 root 權限運行的node_exporter將無法讀取,導致node_textfile_scrape_error標記為 1。因此,腳本在替換檔案前均調用fchmod 0644,並在 CI 測試中加入輸出檔案權限檢查。
標準的 node_exporter 雖然具備 thermal_zone 與 /proc/meminfo 收集器,但無法捕捉本場域最關鍵的兩大致命故障模式:
NV_ERR_NO_MEMORY,此訊號通常比系統 Livelock 早出現數十分鐘。改寫自 Day 12 工具的 gb10-textfile.py,由 systemd timer 每 10 秒觸發一次,輸出包含管線健康狀態在內的 12 個關鍵指標,其中最關鍵的三項如下:
| 指標名稱 | 數據來源 | 監控目的 |
|---|---|---|
gb10_soak_seconds |
核心溫度最高 thermal zone 在 ≥ 88 °C 的累積秒數 | 散熱預算消耗評估。Day 12 防護機制以 240 秒為上限,逾時即中止負載 |
gb10_nv_err_no_memory_total |
dmesg 中 NV_ERR_NO_MEMORY 的累計次數 |
統一記憶體 OOM 的唯一早期預警 |
gb10_hot |
由取樣守護程式建立的 HOT 標記檔 | 提供給不可中斷推論/批次任務在階段間檢查的退避訊號 |
dmesg_restrict,一般使用者無法直接讀取核心日誌。本服務透過 systemd 指派專用系統帳號,僅給予單一 CAP_SYSLOG 權限,並配置 ProtectSystem=strict,僅開放指標目錄與暫存狀態目錄可寫。/proc/meminfo)。因此目前維持以輕量腳本獲取溫度、功耗與利用率。之前場域內部測試有用過 SSH 遠端執行腳本獲取資料。但從安全縱深角度評估,監控收集端是整個網路中連通性最廣的節點,若其持有的 SSH 金鑰具備遠端 Shell 執行權限,一旦收集端遭受滲透,將連帶危及儲存核心。
因此進行責任分工重構:
authorized_keys 嚴格限制來源 IP、強制限制執行單一指令且設定 no-pty。[收集端 Prometheus]
│
├──── SNMP v3 (authPriv, 161/UDP) ────► [QNAP NAS] (硬體狀態、SMART、風扇、溫度、磁碟池)
│
└──── SSH (受限金鑰, 唯讀 ZFS 指令) ─────► [QNAP NAS] (快照數量、佔用空間、資料集詳情)
收集途徑:SNMP(qnap_*) |
收集途徑:受限 SSH Textfile(nas_*) |
|---|---|
| 各磁碟狀態、溫度、SMART 完整屬性表 | 各 ZFS 資料集快照總數、最新/最舊快照時間 |
| RAID 群組與儲存池容量、剩餘空間、健康狀態 | 排除 :init: 標籤後的實際快照佔用量 |
| 共享資料夾配額、WORM 不可變狀態、壓縮/去重旗標 | 依資料集名稱精確列出的 zpool 實際利用率 |
| 風扇轉速、CPU 核心溫度、記憶體總量與使用率 | 服務連線探測指標(nas_up) |
| 韌體版本、服務開關(SSH/FTP/Telnet)、已裝套件 |
authPriv,認證採用 HMAC-SHA,加密採用 DES。密語長度須大於 8 碼以符合 net-snmp 規範。authPriv,收集端誤用 authNoPriv),snmp_exporter 仍會回傳 HTTP 200 且 up == 1,但指標只包含 exporter 本身的計數,導致常規的 TargetDown 告警失靈。為此必須補上一條 NasSnmpNoData 規則檢查樣本數量。up == 0。使用社群成熟的 prometheus-pve-exporter,透過 Proxmox VE 的 REST API 抓取 VM 運作狀態、節點資源利用率、儲存空間與叢集 Quorum 仲裁資訊。
prometheus@pve,在 PVE 根路徑僅賦予 PVEAuditor 唯讀角色,並簽發專用 API Token。權限憑證檔案存於收集端本機,權限設定為 0640,並鎖定容器使用者 GID 存取。instance 標籤過濾,避免統計數字翻倍。Day 16 至 Day 18 的還原演練與雲端卸載腳本,原先會在各自倉庫產生 drills.jsonl。透過 drills-textfile.py 解析日誌,標準化不同模組間的欄位定義差異(例如統一整合 rto_s 與 rto),輸出包含成功狀態、RTO、RPO、傳輸頻寬以及 「距離上次成功還原時間戳」 的時序指標。
# 轉換後的演練指標範例
drill_last_rto_seconds{source="pve",label="d3-full"} 569
drill_last_rpo_seconds{source="pve",label="d3-full"} 784
drill_last_success_timestamp{source="cloud",label="restore-music-to-primary"} 1790898239
這項轉換使原本屬於「點狀事件」的演練紀錄,升級為可持續監看的「連續服務水準(SLO)」指標,能在儀表板上直觀呈現演練新鮮度。
使用 Textfile Collector 最常見的架構隱患是,**取樣腳本已經當掉或定時任務失效,但舊的 .prom 檔案仍留在磁碟上。**此時 node_exporter 依然會定期讀取舊檔案端出數值,Prometheus 看到的是一條平緩正常的數值線,形成看似全綠燈的「靜默失效」。
為解決這種問題,所有取樣用的程式碼一律輸出帶有目前 Unix 時間戳的 *_last_run_timestamp 指標,並在 Prometheus 配置活性檢查警報規則:
# rules/staleness.yml
groups:
  - name: pipeline_staleness
    rules:
      - alert: Gb10TextfileStale
        expr: (time() - gb10_last_run_timestamp) > 120
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: "DGX Spark 硬體取樣腳本已停止更新超過 2 分鐘"

      - alert: NasTextfileStale
        expr: (time() - nas_last_run_timestamp) > 600
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "NAS ZFS 取樣定時任務逾期未回報"

      - alert: NasSnmpNoData
        expr: scrape_samples_scraped{job="nas-snmp"} < 50
        for: 5m
        labels:
          severity: critical
        annotations:
          summary: "NAS SNMP 抓取異常,回傳指標過少(可能為 v3 認證協定不匹配)"
| 警報名稱 | 觸發條件 | 意涵與可能根因 |
|---|---|---|
TargetDown |
up == 0 持續 5 分鐘 |
目標主機宕機或網路中斷 |
Gb10TextfileStale |
執行間隔超過 120 秒 | systemd timer 異常或腳本執行掛起 |
NasTextfileStale |
執行間隔超過 10 分鐘 | Cron 排程未觸發或 SSH 通道異常 |
NasSnmpNoData |
抓取樣本數小於 50 持續 5 分鐘 | SNMPv3 加密/驗證協定配置錯誤 |
NasUnreachable |
nas_up == 0 持續 5 分鐘 |
儲存端 SSH 認證失敗或 ZFS 指令逾時 |
監控系統本身的資源佔用必須具備精確的可預測性。以下為部署後的實際負載測量:
| 監控標的 | 端點數 | 抓取週期 | 平均單目標樣本數 | 每秒樣本產生率 (Samples/s) |
|---|---|---|---|---|
DGX Spark node_exporter(含硬體擴充) |
2 | 15s | ~1,600 | 213.7 |
| QNAP NAS SNMP | 2 | 60s | ~980 | 33.0 |
| 收集端本機(含 NAS/演練文字檔) | 1 | 60s | 879 | 14.7 |
PVE 叢集 pve-exporter |
2 | 60s | 343 | 11.4 |
| Prometheus 自身效能指標 | 1 | 15s | 885 | 59.0 |
| 總計 | 8 | - | 每輪 7,633 樣本 | 約 332 Samples/s |
根據 Prometheus TSDB 實務壓縮率,平均單一樣本佔用約 1.5 位元組。
每日儲存增量 ≈ 332 × 86,400 × 1.5 Bytes ≈ 43 MB / 天
90 天預估儲存 ≈ 43 MB × 90 ≈ 3.87 GB
「指標顯示綠燈(up == 1),只代表 HTTP 埠有通,不代表取樣數值的真實性。」
為驗證 Prometheus 中的時間序列能誠實反映底層狀態,撰寫 verify.sh 自動化驗證腳本,由收集端同時拉取 Prometheus API 的最新值,並透過 SSH 執行來源端原生診斷指令進行比對。
| 監控維度 | 測試目標 | Prometheus 數值 | 原生指令輸出 | 對應底層指令 | 判定結果 |
|---|---|---|---|---|---|
| GPU 溫度 | DGX Spark 01 | 44 °C | 44 °C | nvidia-smi --query-gpu=temperature.gpu |
一致(通過) |
| Thermal Zone | DGX Spark 02 | 45 °C | 45 °C | cat /sys/class/thermal/thermal_zone*/temp |
一致(通過) |
| 可用記憶體 | DGX Spark 01 | 23.97 GB | 23.96 GB | /proc/meminfo: MemAvailable |
誤差小於 0.1%(通過) |
| ZFS 池使用率 | 主 NAS | 26% | 26% | zpool list -H -o cap zpool1 |
一致(通過) |
| 已用快照數 | 兩台 NAS | 0 | 0 | zfs list -t snapshot |
一致(通過) |
| 實體磁碟數 | 主 NAS | 10 顆 | 10 顆 | getsysinfo hdmodel 非空槽位數 |
一致(通過) |
| 池可用空間 | 主 NAS | 9.75 TB | 9.75 TB | zfs get -Hp available zpool1 |
誤差小於 0.01%(通過) |
| 執行中 VM 數 | PVE Node 01 | 5 台 | 5 台 | qm list 執行狀態過濾 |
一致(通過) |
| HA 服務狀態 | PVE 叢集 | 0 errors | 0 errors | ha-manager status |
一致(通過) |
| 最新演練 RTO | 還原管線 | 569 秒 | 569 秒 | drills.jsonl 最新紀錄 |
一致(通過) |
驗證過程的硬體回饋
關於磁碟溫度指標校正,QNAP 專屬指令getsysinfo hdtmp需要 root 權限,非 root 帳號執行僅會回傳空值,因此硬體健康指標調整為透過 SNMP 讀取標準磁碟溫度與 SMART 屬性,避開權限過大的問題。
關於 SNMP 溫度感知機制,SNMP 回傳的 CPU 溫度來自 QTS 系統內部感測器且存在取樣快取,數值與底層coretemp封裝核心溫度存在微小溫差。此數值適合觀測長期溫升趨勢,但不宜直接與標準 Linux 伺服器的核心溫度做絕對值橫向比較。
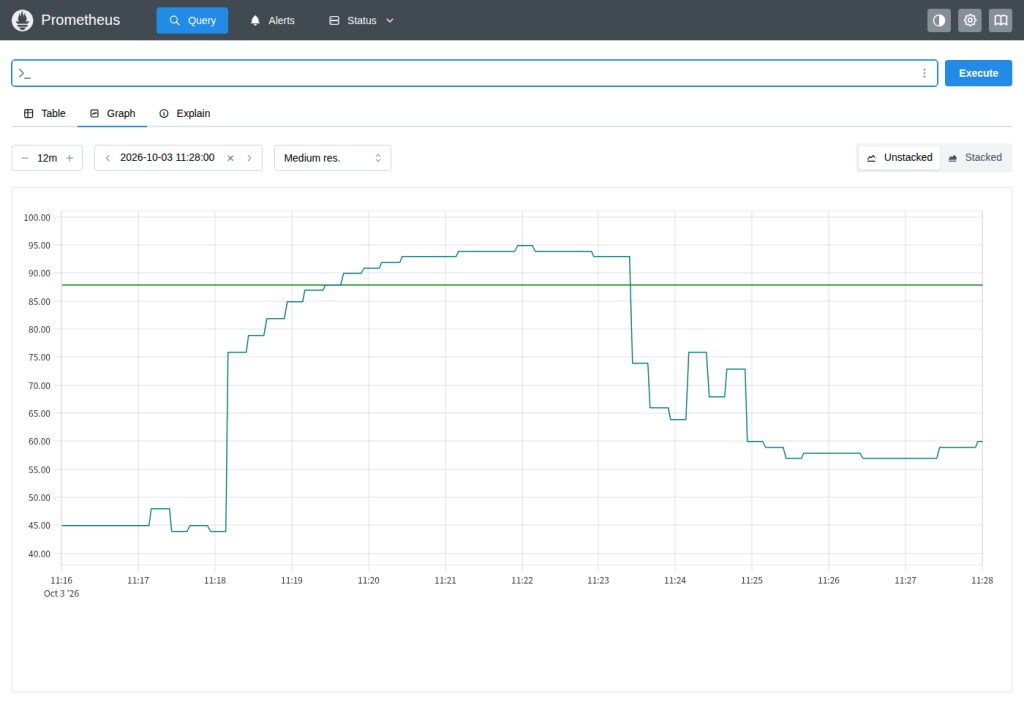
為驗證高溫保護機制在時序指標上的反應,透過矩陣乘法運算對 GPU 施加穩定負載,觀察持續高溫時指標的變化情形:
[測試進程時序]
11:17:49  通過冷卻門檻(GPU 43°C,Zone 44°C),啟動矩陣運算高負載
11:19:13  Thermal Zone 首次越過 88°C 臨界線
11:19:39  Prometheus 記錄到第一個非零 Soak 秒數(21s)
11:21:54  Zone 溫度達到峰值 95°C
11:23:09  防護守護程式判定連續超溫滿 240 秒,強制中止負載行程
11:23:10  負載終止,溫度於 1 秒內迅速回落至 85°C
11:23:24  Prometheus 下一次抓取,Soak 數值歸零
  溫度 (°C)
   100 │                                    [強制中止負載]
    90 │              ┌───────────────────────────┐
    80 │──────────────┘                           └────── (臨界門檻 88°C)
    70 │
    60 │
    50 │  ┌───────────┐
    40 └──┘           └──────────────────────────────────
       11:17         11:19                       11:23
本篇所有操作均遵循最小權限與可回退原則,變更項目統整如下:
| 目標設備 | 變更項目與安全性設定 |
|---|---|
| 運算節點 (DGX Spark) | 安裝 node_exporter;配置 gb10-textfile 服務與計時器(專用系統帳號,僅賦予 CAP_SYSLOG);防火牆僅放行收集端 IP 存取 9100/TCP。 |
| 網路儲存 (NAS) | 啟用 SNMPv3 authPriv(SHA 驗證、DES 加密);配置 SSH 受限公鑰(指定來源 IP 與限制指令)。 |
| 虛擬化叢集 (PVE) | 建立專用監控帳號 prometheus@pve,派發唯讀 Auditor Token。 |
| 監控收集端 (VM) | 部署 Prometheus、snmp_exporter、pve-exporter 容器,配置自動化抓取與健全度規則。 |
# 1. 取得監控建置專案
git clone https://github.com/ivanusto/onprem-metrics && cd onprem-metrics

# 2. 設定目標清單與認證金鑰
cp prometheus/targets/gb10.yml.example prometheus/targets/gb10.yml
cp prometheus/targets/nas-snmp.yml.example prometheus/targets/nas-snmp.yml
cp prometheus/targets/pve.yml.example prometheus/targets/pve.yml
cp prometheus/pve.yml.example prometheus/pve.yml                # 填入 PVE API Token
cp prometheus/snmp-auth.yml.example prometheus/snmp-auth.yml    # 填入 SNMPv3 密碼

# 3. 權限收斂
sudo chown root:101 prometheus/pve.yml && sudo chmod 640 prometheus/pve.yml
sudo chown root:65534 prometheus/snmp-auth.yml && sudo chmod 640 prometheus/snmp-auth.yml

# 4. 驗證配置並啟動監控服務
promtool check config prometheus/prometheus.yml
docker compose up -d

# 5. 受控 GPU 節點端安裝 Exporter 與防火牆設定
sudo ./install-node.sh
sudo ufw allow proto tcp from <COLLECTOR_IP> to any port 9100

# 6. 執行全場域端對端數據驗證
PROM=http://localhost:9090 ./verify.sh \
  --gb10 user@192.168.10.131 --gb10 user@192.168.10.141 \
  --nas primary=ops@192.168.10.2 --nas secondary=ops@192.168.10.22 \
  --pve auditor@192.168.10.9 > verify-report.md
散落各處的取樣工具至此全數接入同一個 Prometheus 時間序列資料庫。透過 Pull 架構的解耦、最小權限防護設計,以及 Textfile 活性檢測機制,這次建立了一個兼顧安全性與即時性的監控基底。
有了這些標準化的時序數據,Day 20 將進入視覺化與預警階段,預期將利用 Grafana 打造整合運算節點 Soak 歷程、NAS 儲存池動態、PVE 叢集 Quorum 與災難還原間隔(距上次演練成功天數)的核心維運儀表板,並基於今日測試到的抓取延遲,調校出真正具備預警效力的告警規則。


 iThome鐵人賽
 看影片追技術